
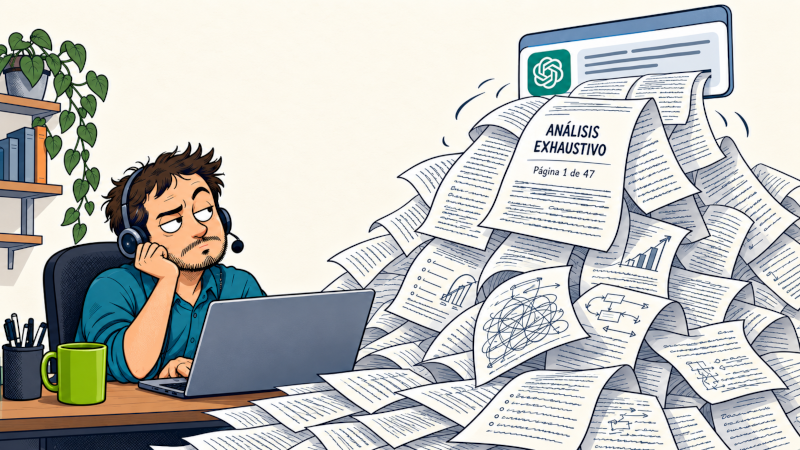
Los modelos de lenguaje pueden ayudarnos a trabajar mejor. Sirven para ordenar información, explicar conceptos y preparar consultas comprensibles. En Occentus Network reconocemos ese valor. Pero también debemos señalar un problema: enviar una respuesta generada por IA sin revisarla puede trasladar al equipo de soporte más trabajo del que ahorra.
Una solicitud puede ocupar cinco páginas, utilizar vocabulario técnico y presentar conclusiones con seguridad, y aun así omitir el dato imprescindible para empezar: qué falla y dónde.
La apariencia de un diagnóstico no equivale a un diagnóstico.
Se suele llamar AI slop al contenido de baja calidad generado con inteligencia artificial. En el ámbito laboral, el término workslop describe una manifestación especialmente problemática: materiales que parecen terminados y profesionales, pero carecen de la sustancia necesaria para hacer avanzar el trabajo. Quien los recibe tiene que interpretarlos, corregirlos o reconstruir la información que falta.
La investigación de BetterUp Labs y Stanford, difundida por Harvard Business Review en septiembre de 2025, recoge que el 41 % de los trabajadores encuestados había encontrado este tipo de contenido y que cada caso suponía casi dos horas de trabajo adicional. Son resultados declarados por los participantes, no una medición de nuestro servicio de soporte. Pero ayudan a poner nombre a un coste que conviene considerar: el tiempo de quien recibe el contenido también cuenta.
En soporte técnico, ese coste aparece cuando debemos separar los hechos de las suposiciones. Un texto generado puede mezclar síntomas reales con causas posibles, describir pruebas que nadie ha ejecutado o recomendar cambios sin conocer la configuración del servicio. En algunas ocasiones, además, produce párrafos largos e inconexos, con razonamientos sin sentido que dificultan localizar la información útil.
Pensemos en un ejemplo ficticio (o no tanto). Un cliente no puede acceder a su web y consulta a un LLM. Después remite un informe sobre DNS, certificados, cachés y posibles fallos de infraestructura. El mensaje propone varias intervenciones, pero no incluye la URL, la hora del fallo ni el error que muestra el navegador.
Antes de investigar, tenemos que pedir esos datos y aclarar qué comprobaciones se han realizado realmente. El informe ha añadido una tarea previa: reconstruir la incidencia.
Si ese mismo cliente escribe «al entrar en esta URL aparece este error desde esta mañana» y adjunta el mensaje original, ya tenemos un punto de partida. No necesita identificar la causa ni dominar la terminología técnica. Esa parte nos corresponde a nosotros.
No esperamos que el cliente llegue con un diagnóstico. Necesitamos que describa su problema con fidelidad.
Tampoco se trata de exigir brevedad a cualquier precio. Una incidencia compleja puede requerir registros extensos, una cronología detallada y varias pruebas. Esa información es necesaria cuando aporta evidencias. Lo que dificulta el trabajo es el volumen de texto que repite ideas, inventa contexto o presenta posibilidades como conclusiones.
Por eso, al abrir una solicitud, pedimos:
- El servicio, dominio o recurso afectado.
- Qué ocurre, desde cuándo y cómo se reproduce, si se conoce.
- El mensaje de error original y los registros relevantes.
- Qué resultado se esperaba o qué intervención se solicita.
- Qué pruebas o cambios se han realizado y cuál ha sido su resultado.
Si has utilizado un LLM, agradecemos que compartas también el prompt y el contexto relevante, retirando cualquier dato sensible. A menudo, la pregunta original explica mejor tu necesidad que la respuesta generada. Identifica las propuestas de la herramienta como sugerencias y distingue las acciones ejecutadas de las pendientes.
Si has utilizado un LLM, agradecemos que compartas también el prompt y el contexto relevante
Puedes utilizar IA para estructurar la consulta, mejorar la redacción o comprobar si falta información. Antes de enviarla, revisa que cada afirmación corresponda a algo observado y que los datos originales sigan presentes. Si no sabes si una explicación es correcta, indícalo.
En Occentus Network aplicamos este criterio en nuestra política sobre LLM en solicitudes de soporte: preferimos los datos en bruto, el problema concreto y el resultado esperado a una interpretación extensa sin verificar.
Generar un texto en segundos no supone un ahorro si otra persona necesita mucho más tiempo para averiguar qué ha ocurrido. Usar bien la IA también implica hacerse responsable de lo que se envía. Consulta nuestra política sobre LLM y solicitudes de soporte